Comparez plusieurs modèles pour optimiser vos performances
Le contrôle automatisé que vous avez mis en place au chapitre précédent a porté ses fruits. L'équipe Risque est ravie de votre rigueur : les vérifications personnalisées ont formellement bloqué le modèle de régression logistique initial. En effet, votre algorithme ne respectait pas les objectifs stricts de rentabilité financière de la banque.
Consciente des limites de ce premier jet, l'équipe de modélisation vient de vous fournir un modèle alternatif beaucoup plus complexe et robuste, basé sur un algorithme de Gradient Boosting (arbres de décision). En tant que garant de la qualité de ce projet, la balle est de nouveau dans votre camp.
Dans ce chapitre, vous devez soumettre ce nouvel algorithme à une validation croisée rigoureuse, ajuster son seuil de décision pour minimiser les pertes financières, et enfin, éditer un comparatif chiffré irréfutable pour prouver à votre direction quel modèle doit être définitivement mis en production.
Évaluez un modèle alternatif par validation croisée
Avant de crier victoire et d'affirmer que ce nouveau modèle d'arbres de décision est le sauveur de la banque, il faut s'assurer que ses performances sont réelles et non dues à un simple coup de chance. Jusqu'à présent, nous avions évalué notre algorithme en mettant de côté 20 % des données pour le test. Mais que se passerait-il si, par hasard, ces 20 % contenaient les clients les plus faciles à prédire ?
Pour obtenir une évaluation véritablement robuste, nous devons utiliser la validation croisée (ou cross-validation).
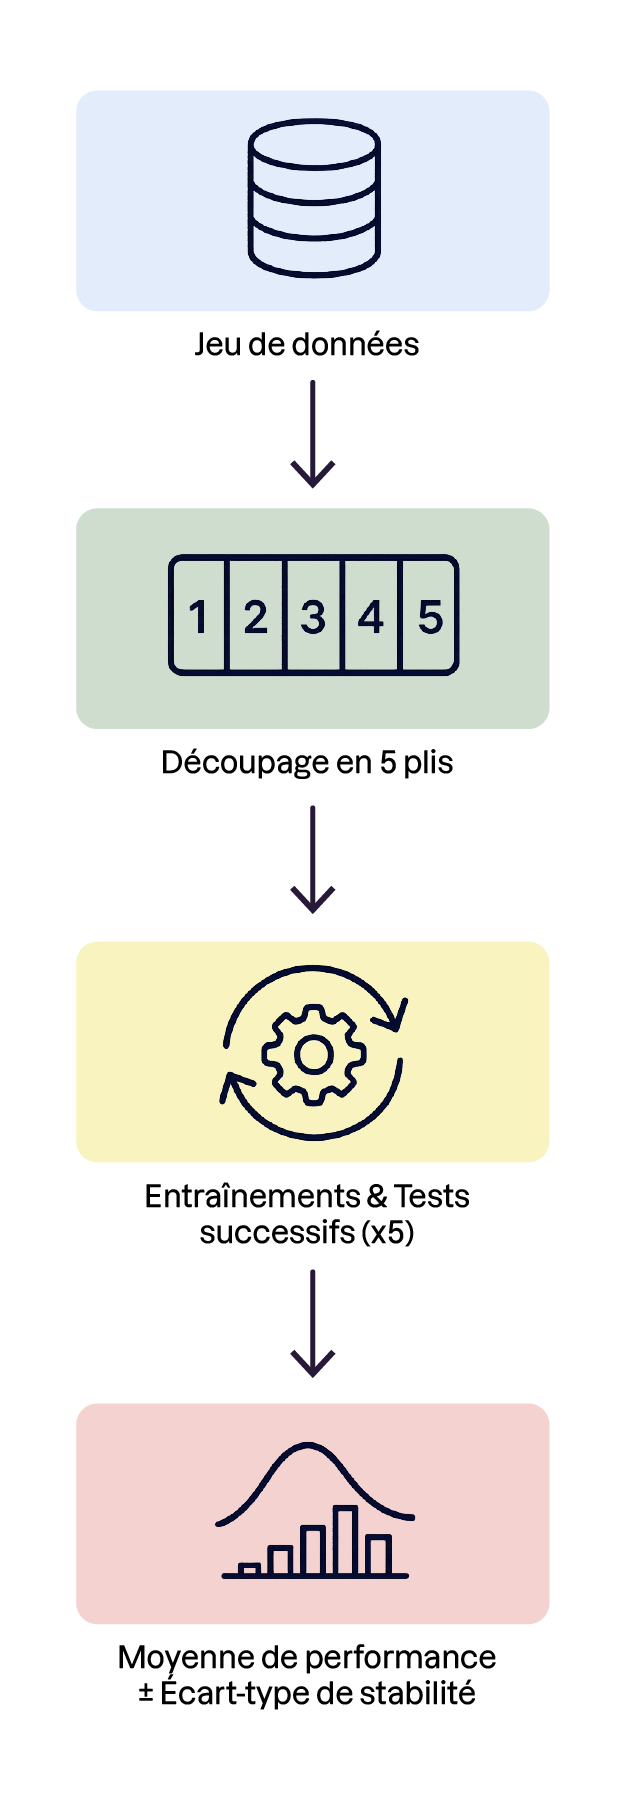
Cette technique vous permet de vérifier deux points cruciaux :
La moyenne des scores vous indique la performance générale et réelle du modèle.
L'écart-type (la variation entre les plis) vous indique la stabilité de votre modèle. Un écart-type élevé signifie que l'algorithme est instable et très dépendant des données qu'on lui fournit.
Skore facilite grandement cette étape grâce à son objetCrossValidationReport.
Vous allez apprendre à évaluer la stabilité du nouveau modèle de Gradient Boosting. Vous allez découvrir comment passer d'une simple séparation train/test à une validation croisée robuste en ne modifiant qu'un seul paramètre dans la fonction de Skore.
En utilisant un entier pour le paramètre splitter, vous avez généré unCrossValidationReportprouvant la stabilité de votre nouvel algorithme sur l'ensemble des données. Cependant, même si les scores globaux s'améliorent, l'algorithme souffre encore du déséquilibre des classes bancaires. Pour le rendre réellement rentable face à notre "Strict Credit Gain", nous allons devoir intervenir manuellement sur sa façon de prendre des décisions.
Ajustez le seuil de décision de vos probabilités prédictives
La grande majorité des algorithmes de classification, y compris notre Gradient Boosting, ne prédisent pas directement un "Oui" ou un "Non". Ils calculent une probabilité (souvent via la méthode.predict_proba()). Par défaut, scikit-learn et Skore utilisent un seuil de décision stricte fixé à 0,5 : si la probabilité de faire défaut est supérieure à 50 %, on refuse le crédit ; sinon, on l'accepte.
Mais ce seuil de 50 % est-il logique pour notre banque ?
Rappelez-vous la politique de l'équipe Risque : un défaut de paiement (faux négatif) nous coûte 10 fois plus cher que de refuser un bon client (faux positif). Face à un tel risque financier, la banque ne peut pas se permettre d'attendre d'être sûre à 50 % qu'un client va faire défaut ! Même si la probabilité de risque n'est estimée qu'à 25 % ou 30 %, le coût potentiel est si grand qu'il vaut mieux bloquer le crédit.
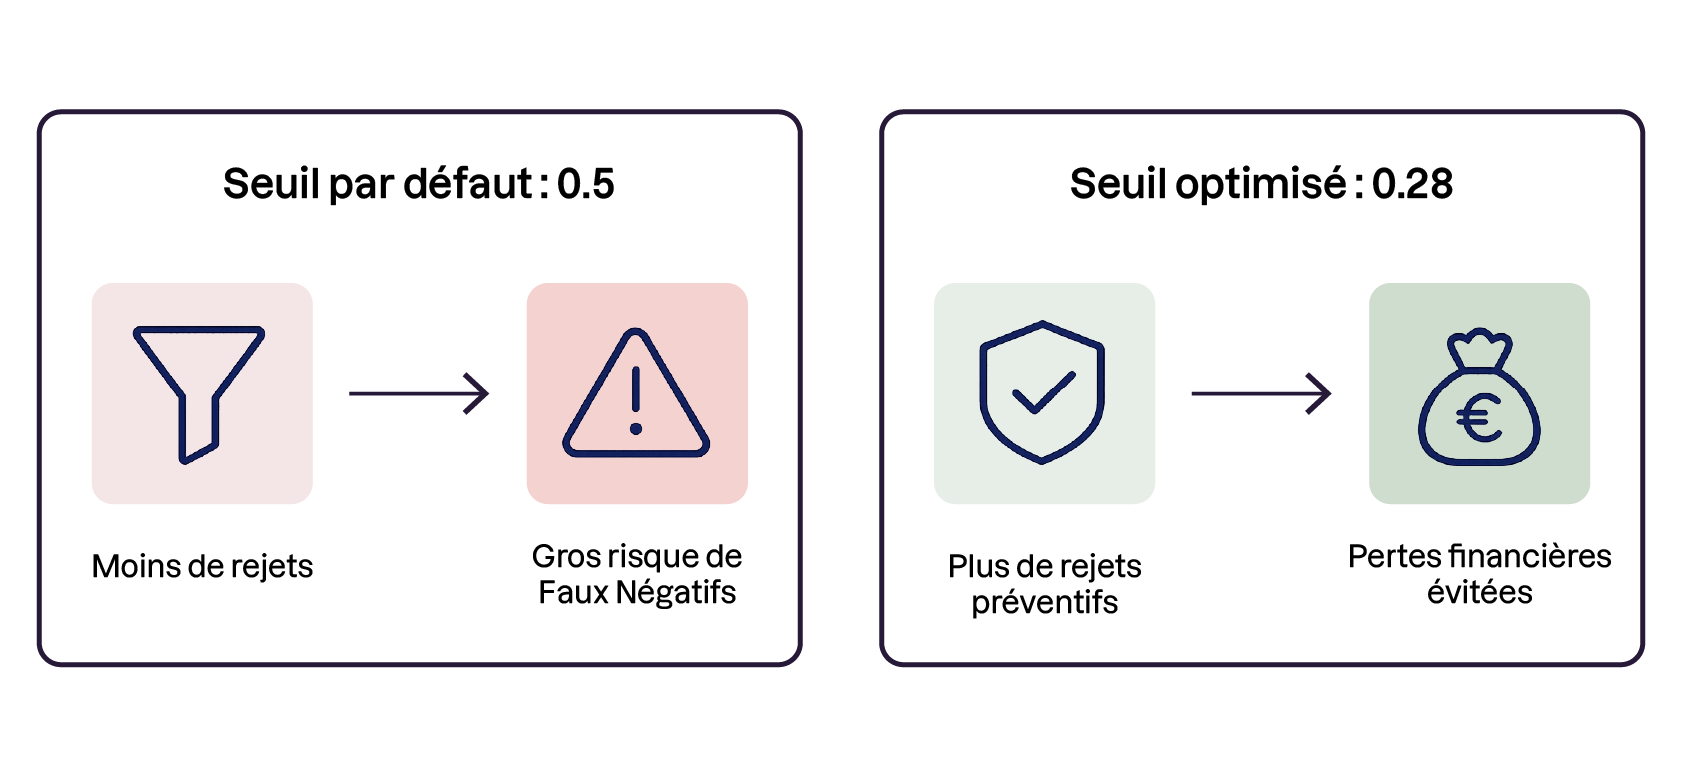
Ajuster ce seuil de décision est la clé pour aligner l'algorithme sur vos contraintes financières.
L'objectif est de vous montrer l'impact dramatique du seuil de décision sur vos métriques métiers. Vous allez apprendre à utiliser les outils visuels de Skore pour trouver le seuil parfait, celui qui offre le meilleur compromis entre la précision statistique et le gain financier.
Vous venez de constater qu'un seuil optimisé métier diminue souvent l'Accuracy, mais améliore fortement le gain financier de l'entreprise. Ce compromis est exactement ce que cherche la direction. Il ne vous reste plus qu'à officialiser cette découverte en mettant face à face l'ancien et le nouveau modèle au sein d'un rapport de comparaison.
Éditez un rapport de comparaison pour sélectionner le meilleur modèle
Votre direction ne lira pas votre code Python. Elle a besoin d'une synthèse visuelle, claire et argumentée pour comprendre pourquoi elle devrait financer la mise en production du modèle de Gradient Boosting optimisé plutôt que la régression logistique initiale.
Skore propose justement la classeComparisonReport. Cet outil centralise plusieurs rapports d'évaluation (qu'il s'agisse d'unEstimatorReportou d'unCrossValidationReport) dans une même vue comparative interactive. Une vue comparative met instantanément en évidence les écarts de performance entre vos expérimentations et sert de support objectif pour justifier le choix du modèle final.
L'objectif de cette ultime vidéo est de vous apprendre à générer un rapport de comparaison Skore. Vous allez voir comment fusionner les évaluations de vos deux modèles concurrents dans une interface unique pour sélectionner le grand vainqueur.
La fonctionskore.compare()est l'outil parfait pour clôturer une phase d'expérimentation. Le rapport de comparaison met fin aux débats mathématiques en apportant des preuves chiffrées sur les critères qui intéressent vraiment le métier. C'est à vous de rédiger la conclusion de ce projet !
À vous de jouer !
Contexte
Dans la vidéo précédente, vous avez comparé votre régression logistique à un Gradient Boosting grâce à une validation croisée etskore.compare. Au seuil de décision par défaut, la régression logistique l'a emporté sur le Credit Gain. Plutôt que de complexifier le modèle, l'équipe Data Science a donc poussé l'optimisation plus loin en ajustant directement le seuil de décision de la régression logistique.
Le comité de direction se réunit cet après-midi. Le directeur des risques et la directrice de la conformité vous ont demandé un verdict final clair : doivent-ils déployer cette version ajustée à la place du modèle actuel ? Vous devez comparer les deux rapports et vérifier si l'ajustement du seuil améliore réellement les performances métiers de la banque.
Dans cet exercice, vous allez :
construire un rapport
skorerobuste grâce à la validation croisée, en donnant un entier au paramètresplitter,ajuster automatiquement le seuil de décision de votre régression logistique avec
TunedThresholdClassifierCV, pour maximiser une métrique métier plutôt que l'exactitude,regrouper deux rapports
skoredans unComparisonReportgrâce àskore.compare,traduire ce comparatif en une recommandation chiffrée pour le comité de direction.
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, make_scorer
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from skore import evaluate

home_loans = pd.read_csv("home_loans.csv")
target = home_loans["defaut"]
data = home_loans.drop(columns="defaut")


def strict_business_gain(y_true, y_pred):
    tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()
    return tn * 1 + fp * (-1) + fn * (-10) + tp * 0


strict_gain_scorer = make_scorer(strict_business_gain, greater_is_better=True)

scaled_model = make_pipeline(StandardScaler(), LogisticRegression())
logistic_report = evaluate(scaled_model, data, target, splitter=5, pos_label=1)
logistic_report.metrics.add(strict_gain_scorer, name="Strict Credit Gain")
logistic_report.metrics.summarize()Consigne
Ajustez automatiquement le seuil de décision de
scaled_modelavecTunedThresholdClassifierCV, en lui passantstrict_gain_scorercommescoring. Évaluez ce modèle ajusté avecevaluate(les mêmes paramètres quelogistic_report,splitter=5, pos_label=1) dans un rapporttuned_model_report, ajoutez-lui la métrique "Strict Credit Gain", et affichez son résumé.Regroupez
logistic_reportettuned_model_reportdans un rapport de comparaison avecskore.compare, puis affichezcomparatif.metrics.summarize()Appuyez-vous sur la métrique "Strict Credit Gain" pour recommander formellement, en 3 à 5 lignes, le modèle à conserver pour le comité de direction.
En résumé
Une évaluation robuste passe par la validation croisée (
CrossValidationReport), que Skore génère très facilement en donnant un nombre entier au paramètresplitterde la fonction d'évaluation.Le seuil de probabilité par défaut (50 %) de
scikit-learnest rarement optimal pour des problèmes métiers où les coûts des faux positifs et faux négatifs sont asymétriques.Ajuster le seuil de décision avec les outils visuels (
.metrics.roc().plot()et.metrics.precision_recall().plot()) fait souvent baisser l'exactitude (Accuracy) tout en augmentant radicalement le gain financier.La fonction
skore.compare()centralise vos résultats dans unComparisonReportinteractif, idéal pour justifier objectivement le choix du modèle final auprès des parties prenantes.
Maintenant que vous savez comparer deux modèles avec Skore, voyons dans le dernier chapitre comment utiliiser les Skills avec un agent IA.