Évaluez votre modèle initial avec Skore
Vous venez de créer un premier modèle de référence pour votre banque. Il s'agit d'une régression logistique chargée de prédire les défauts de paiement de vos clients. Vous lancez l'évaluation classique et vous obtenez un résultat qui semble fantastique : votre modèle affiche une exactitude (Accuracy) de ~95% !
Vous vous dites sans doute que le travail est terminé et que vous pouvez déployer ce modèle en production. Mais attention, face à des données bancaires, qui sont par nature souvent déséquilibrées, ce score est-il vraiment le reflet de la réalité, ou bien un simple miroir aux alouettes ?
Dans ce chapitre, vous allez apprendre à utiliser la bibliothèque Skore pour réaliser un véritable "bilan de santé" de votre algorithme. L'objectif est de dépasser la surface des métriques globales et de dévoiler les failles potentielles qui se cachent derrière cette exactitude flatteuse.
Analysez et explorez vos données de départ
Avant même de regarder les prédictions de votre modèle, vous devez impérativement comprendre sur quelles données il a été entraîné. La qualité et la répartition de vos données d'entraînement dictent directement le comportement futur de votre algorithme. Dans de nombreux cas, comme la détection de fraude ou de défaut de paiement, les données présentent une particularité majeure : l'événement que vous cherchez à prédire est rare. La majorité de vos clients remboursent leurs crédits, et seule une petite fraction fait défaut.
C'est ce que l'on appelle le déséquilibre des classes (ou class imbalance en anglais). Si vous ne prenez pas garde à ce déséquilibre dès la phase de préparation des données, toutes vos évaluations ultérieures seront biaisées.
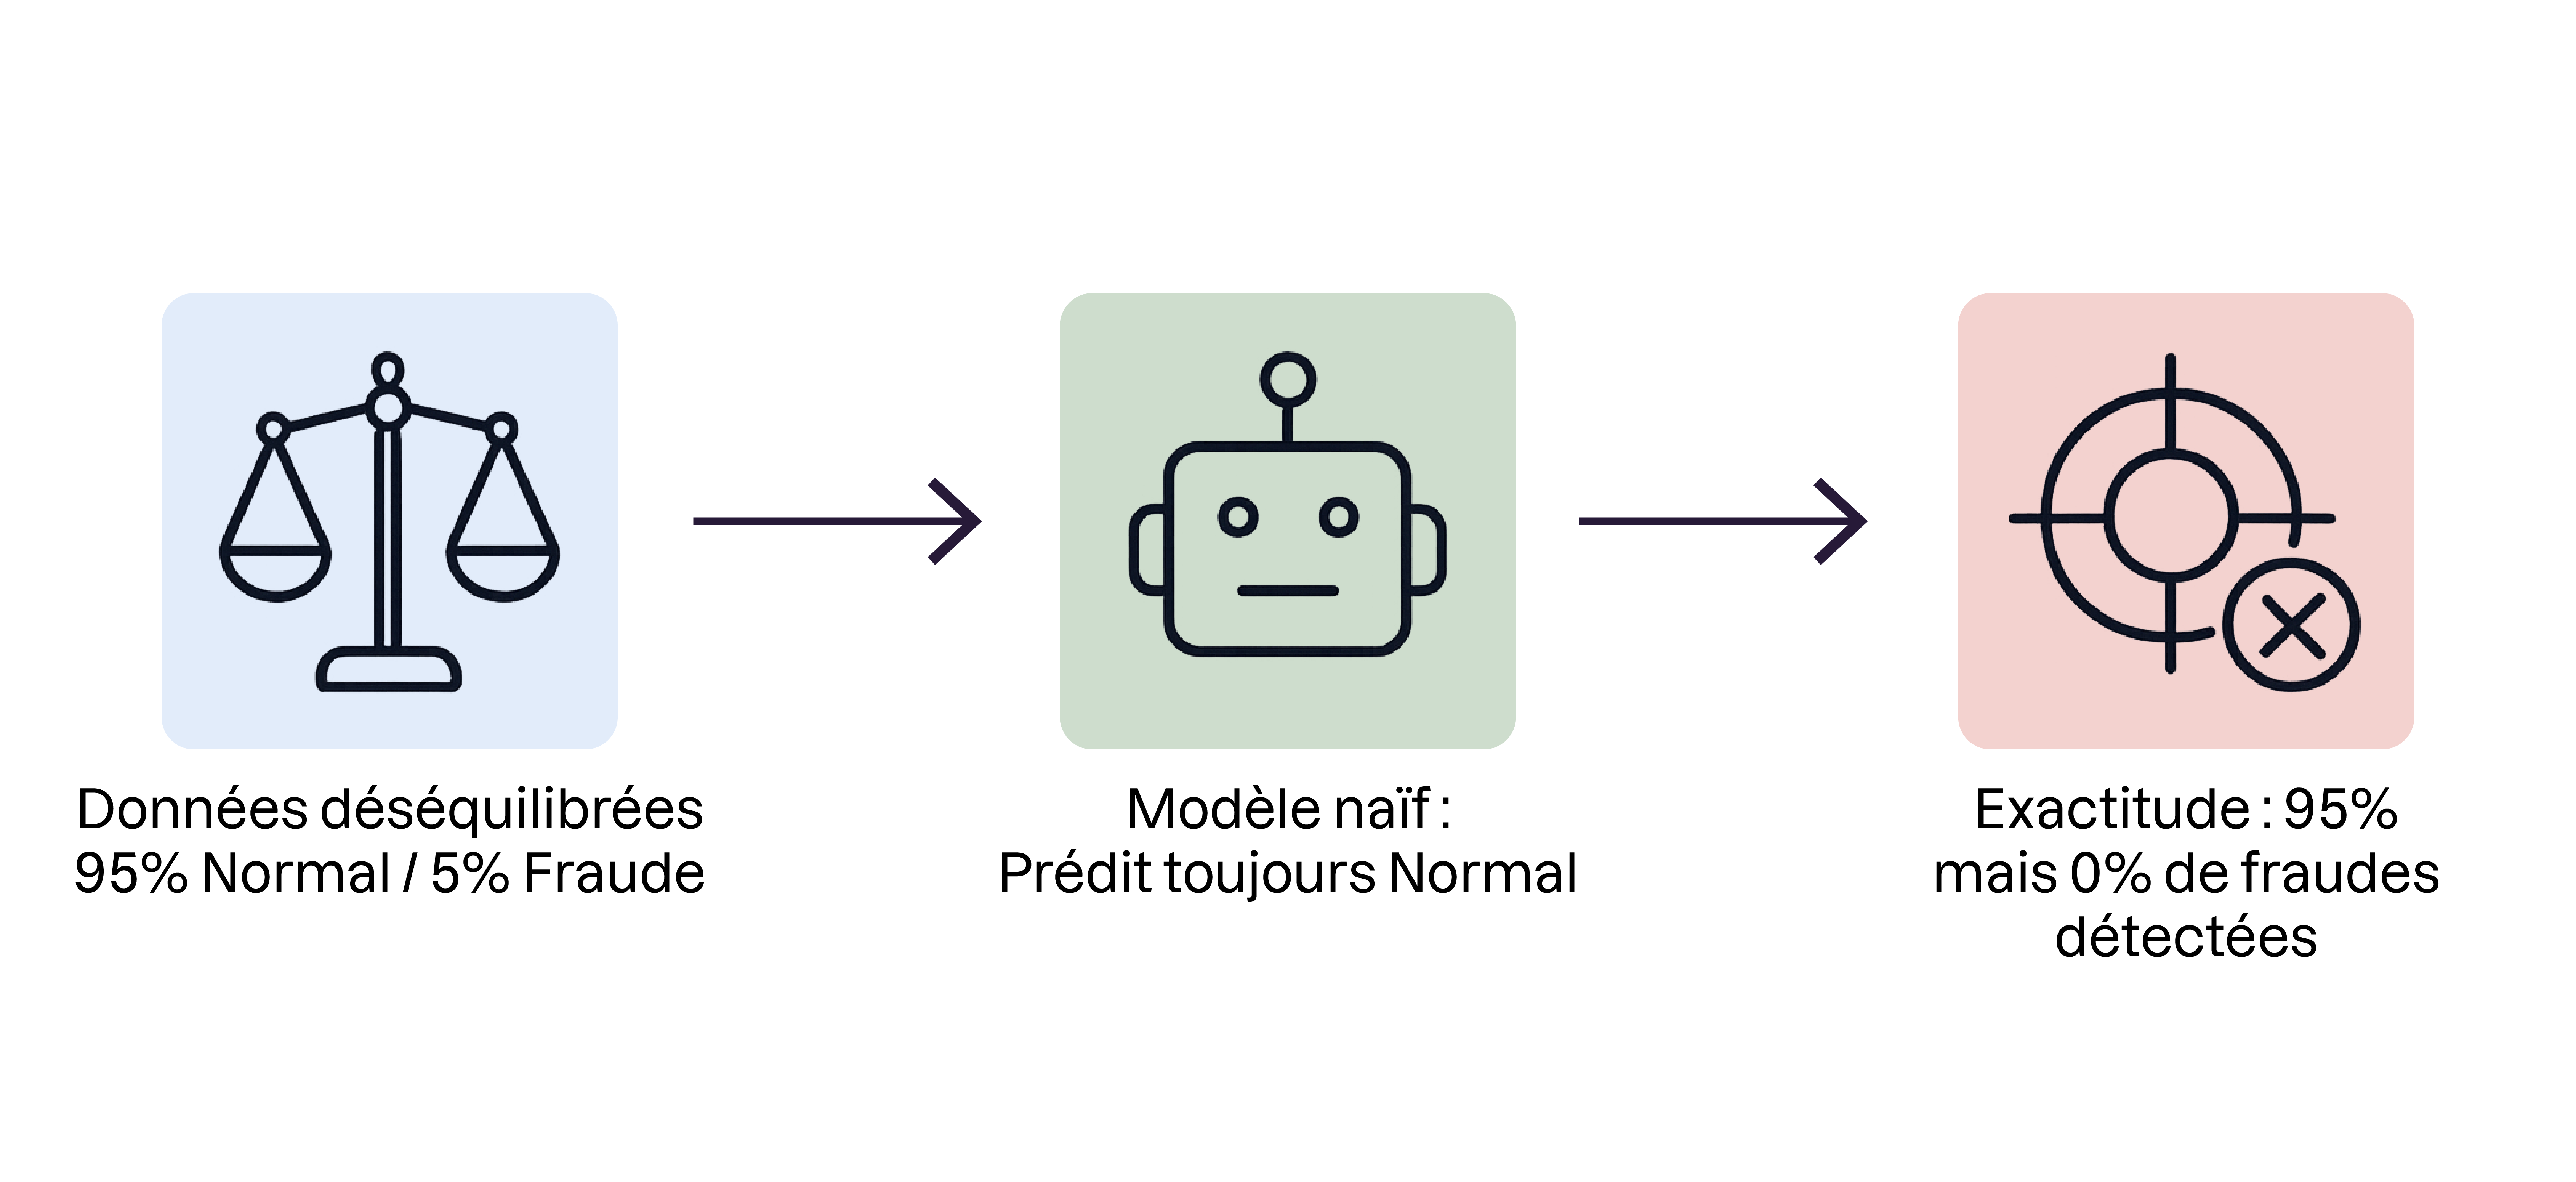
Nous allons explorer ici une façon d’avoir un premier aperçu de ces données.
Vous allez voir comment repérer un déséquilibre de classes dans votre variable cible et comprendre pourquoi il constitue un danger méthodologique majeur. À travers un exemple concret, vous découvrirez qu'un modèle peut afficher une excellente exactitude tout en étant totalement inutile, et pourquoi il est crucial de disposer d'outils adaptés pour ne pas tomber dans ce piège.
Dans cette vidéo, vous avez compris qu'une exactitude de ~95% n'a aucune valeur si elle se contente de refléter la proportion de la classe majoritaire.
Maintenant que le piège de l'exactitude est démasqué, voyons comment générer un rapport complet pour analyser les véritables performances de votre modèle.
Générez un rapport d'estimateur pour analyser les performances
Maintenant que vous avez pris conscience du déséquilibre de vos données, vous devez évaluer votre modèle avec des métriques adaptées.
Comprenez bien que chaque métrique statistique évalue une facette très différente des performances de votre algorithme :
L'Accuracy (exactitude) donne une vue globale du nombre de bonnes prédictions, mais masque les erreurs sur les classes minoritaires.
Le Recall (rappel) mesure la capacité de votre modèle à trouver tous les clients qui vont réellement faire défaut. Dans notre contexte bancaire, c'est souvent la métrique la plus critique !
La Precision (précision) indique la proportion de véritables défauts de paiement parmi tous les clients que le modèle a ciblés comme étant à risque.
Je vais vous guider pas à pas dans la création d'un rapport d'évaluation complet avec Skore. L'objectif est de vous familiariser avec l'interface interactive du rapport et d'apprendre à croiser différentes métriques pour juger objectivement de la qualité de votre modèle.
Vous savez désormais comment générer un EstimatorReport et naviguer dans ses métriques. Cette démonstration a confirmé nos soupçons : l'exactitude de ~95% cachait un rappel désastreux. Le modèle échoue dans sa mission principale.
Mais pourquoi échoue-t-il ainsi ? S'agit-il d'un manque de complexité, ou d'un problème lié aux données elles-mêmes ?
C'est ce que nous allons découvrir grâce aux checks automatisés.
Examinez les diagnostics automatisés pour détecter les anomalies
Jusqu'à présent, nous avons réalisé une évaluation. Il est crucial de bien faire la différence entre l'évaluation et le diagnostic.
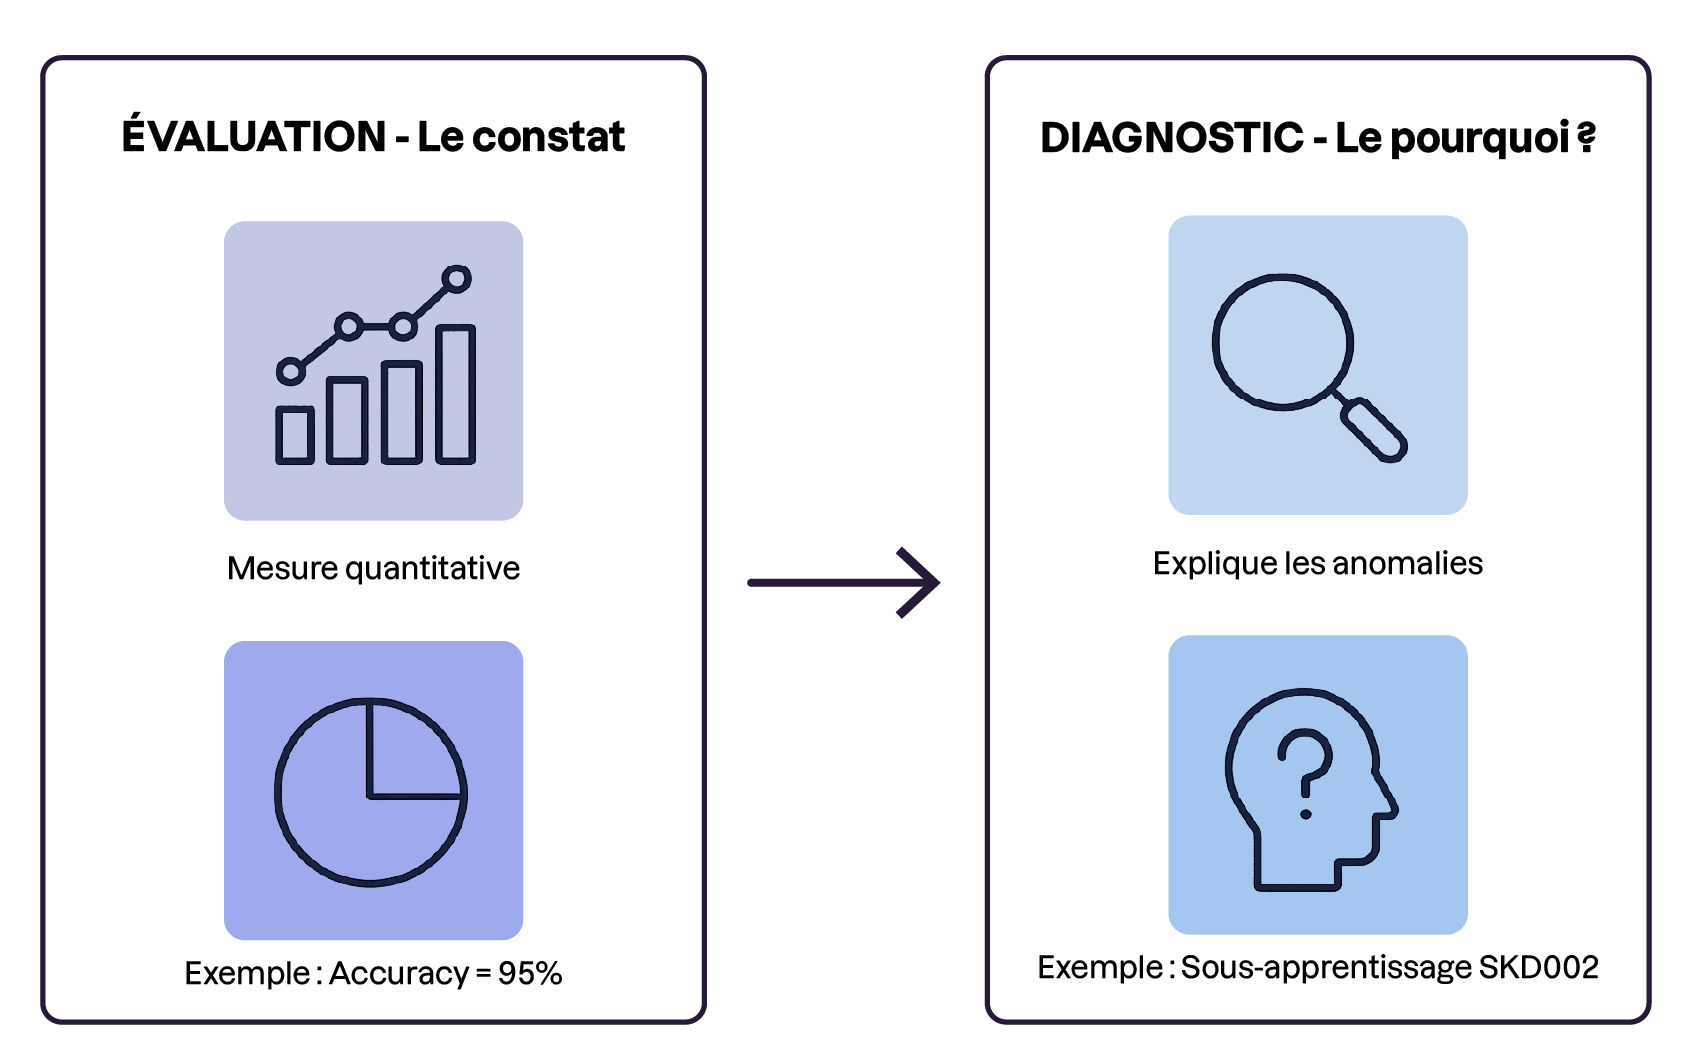
Par exemple, un modèle peut souffrir de sous-apprentissage (underfitting). Cela se produit lorsque votre modèle est trop simple, ou insuffisamment entraîné, pour capturer les relations complexes cachées dans vos données d'entraînement. La régression logistique, étant un modèle linéaire simple, y est particulièrement sujette. Skore intègre un moteur de règles capable de traquer automatiquement ces anomalies.
Vous allez explorer la fonctionnalité de “checks” automatiques de Skore. Vous allez apprendre à lancer des vérifications algorithmiques de santé sur votre modèle et à interpréter les recommandations fournies pour orienter vos futures optimisations.
Grâce à la méthode.checks.summarize(), vous ne naviguez plus à l'aveugle. Skore a confirmé que le modèle était en situation de sous-apprentissage et a identifié un problème de mise à l'échelle des variables. L'outil vous donne directement la feuille de route pour améliorer vos résultats. C'est le moment de mettre ces concepts en pratique par vous-même !
À vous de jouer !
Contexte
Votre manager vient de recevoir votre premier tableau de bord. Il est ravi, votre régression logistique affiche une exactitude proche de 90 %. Il vous écrit dans la foulée pour savoir si ce modèle peut partir en production dès lundi, afin de détecter automatiquement les défauts de paiement des nouveaux clients.
Vous venez de voir qu'une exactitude flatteuse peut cacher un modèle qui n'a rien appris. Avant de répondre à votre manager, vérifiez si c'est le cas ici, et si oui, pourquoi.
Dans cet exercice, vous allez :
construire un
EstimatorReportpour dépasser la seule lecture de l'exactitude,repérer, grâce au rappel (Recall), si le modèle détecte réellement les défauts de paiement,
lancer les checks automatisés de
skorepour en identifier la cause,traduire ce diagnostic en une recommandation claire pour votre manager.
import pandas as pd

home_loans = pd.read_csv("home_loans.csv")
target = home_loans["defaut"]
data = home_loans.drop(columns="defaut")
home_loans
Consigne
Entraînez une régression logistique à échelle à l’aide d’une pipeline scikit-learn (
make_pipeline(StandardScaler(), LogisticRegression())) et évaluez-la avecskore.evaluate, en réservant 20 % des données pour le test grâce au paramètresplitterAffichez le tableau de métriques du rapport et repérez le rappel (Recall) associé au label
1(un défaut de paiement).Lancez les checks automatisés en mode rapide (
fast_mode=True) et notez les alertes classées dans la catégorie Issues.Rédigez, dans une cellule Markdown, une réponse de 3 à 5 lignes à votre manager en vous appuyant sur ces résultats pour statuer sur la mise en production.
En résumé
L'utilisation des checks permet de détecter immédiatement les déséquilibres de classes fréquents dans les données bancaires grâce à des avertissements automatiques.
L'exactitude (Accuracy) est une métrique trompeuse sur des jeux de données déséquilibrés ; il est indispensable d'analyser le rappel (Recall) pour évaluer la vraie capacité de détection du modèle.
La fonction
skore.evaluatepermet de générer un rapport interactif (EstimatorReport) centralisant et synthétisant instantanément l'ensemble des métriques de classification.Contrairement à la simple évaluation, la méthode
checks.summarize()effectue un véritable bilan de santé algorithmique pour expliquer les causes profondes des mauvaises performances.Les alertes automatisées, comme le code SKD002, permettent d'identifier formellement des problèmes méthodologiques graves comme le sous-apprentissage (underfitting) avant tout déploiement en production.
Maintenant que vous êtes capable d'évaluer la santé algorithmique de votre modèle et de déjouer les pièges des métriques statistiques standards, rendez-vous dans le prochain chapitre pour franchir l'étape suivante : apprendre à intégrer vos propres contraintes métiers et financières grâce à la création de métriques personnalisées !